Clustering (Agrupamiento)
Modelos de Machine Learning No-Supervisados
📌 Dr. Cristian Candia
🎓 Universidad del Desarrollo (UDD), Chile
- 🏢 Director, Computational Research in Social Sciences Lab
- 🔬 Faculty, Data Science Institute, School of Engineering
🎓 Northwestern University, United States
- 🔬 External Faculty, Northwestern Institute on Complex Systems (NICO), Kellogg School of Management
🚀 Founder
- 🦫 Capybara
Definición:
El clustering (agrupamiento) es una técnica que busca descubrir subgrupos dentro de un conjunto de datos de manera automática, sin necesidad de etiquetas previas. Es especialmente útil para la segmentación de datos en patrones homogéneos.
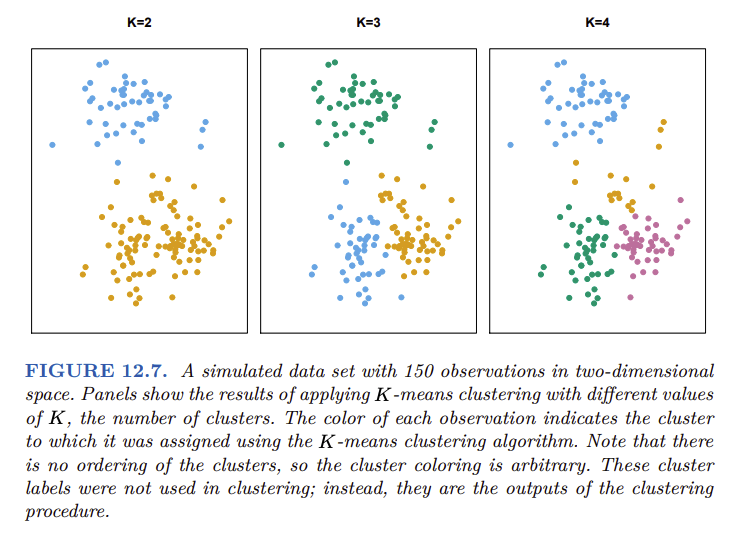
Existen diversos algoritmos de clustering, pero nos enfocaremos en:
K-Means
Uno de los métodos más utilizados en aprendizaje no supervisado es K-Means, que busca particionar $ n $ observaciones en $ K $ grupos, minimizando la varianza dentro de cada grupo.
Definición formal
Dado un conjunto de datos $ X = \{x_1, x_2, ..., x_n\} $ con $ x_i \in \mathbb{R}^d $, K-Means busca encontrar $ K $ centroides $ C = \{c_1, c_2, ..., c_K\} $ que minimicen la siguiente función de costo:
$J = \sum_{i=1}^{n} \sum_{k=1}^{K} \mathbf{1}(z_i = k) ||x_i - c_k||^2$
donde:
- $ z_i $ es la asignación de la observación $ x_i $ al clúster $ k $.
- $ ||x_i - c_k||^2 $ es la distancia euclidiana entre $ x_i $ y su centroide correspondiente $ c_k $.
- La función indicadora $ \mathbf{1}(z_i = k) $ vale 1 si $ x_i $ pertenece al clúster $ k $ y 0 en caso contrario.
Conceptos clave en K-Means:
- Centroide: Punto medio de cada cluster, que representa la posición promedio de sus observaciones.
- Varianza intra-cluster: Medida de dispersión de los datos dentro de un cluster; un menor valor indica que los puntos están más cerca del centroide.
- Asignación de clusters: Cada punto es asignado al cluster cuyo centroide esté más cercano en términos de distancia euclidiana.
Algoritmo K-Means
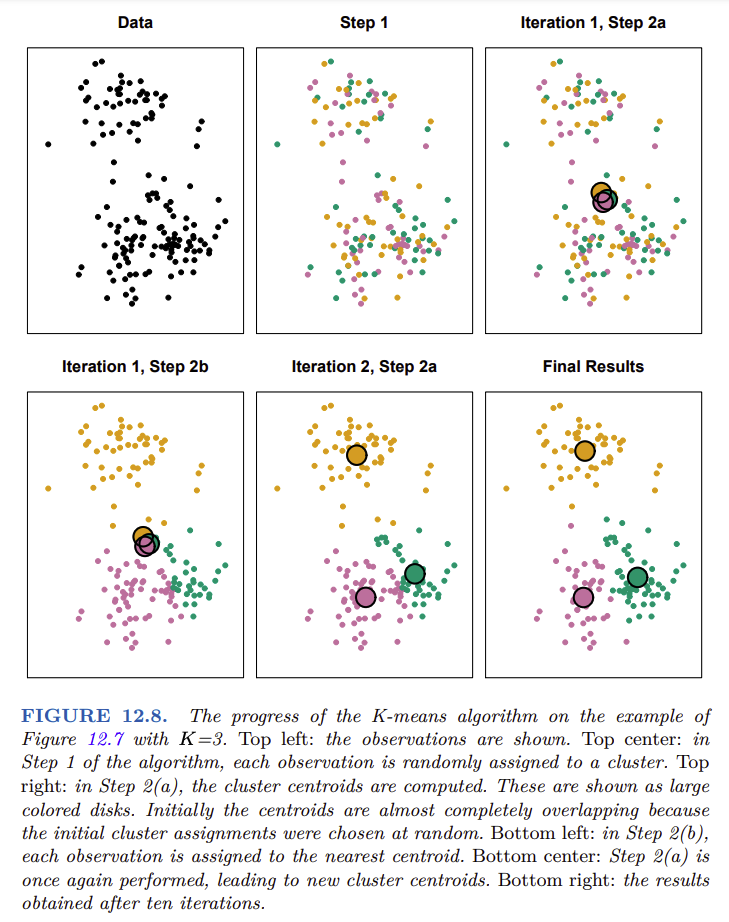
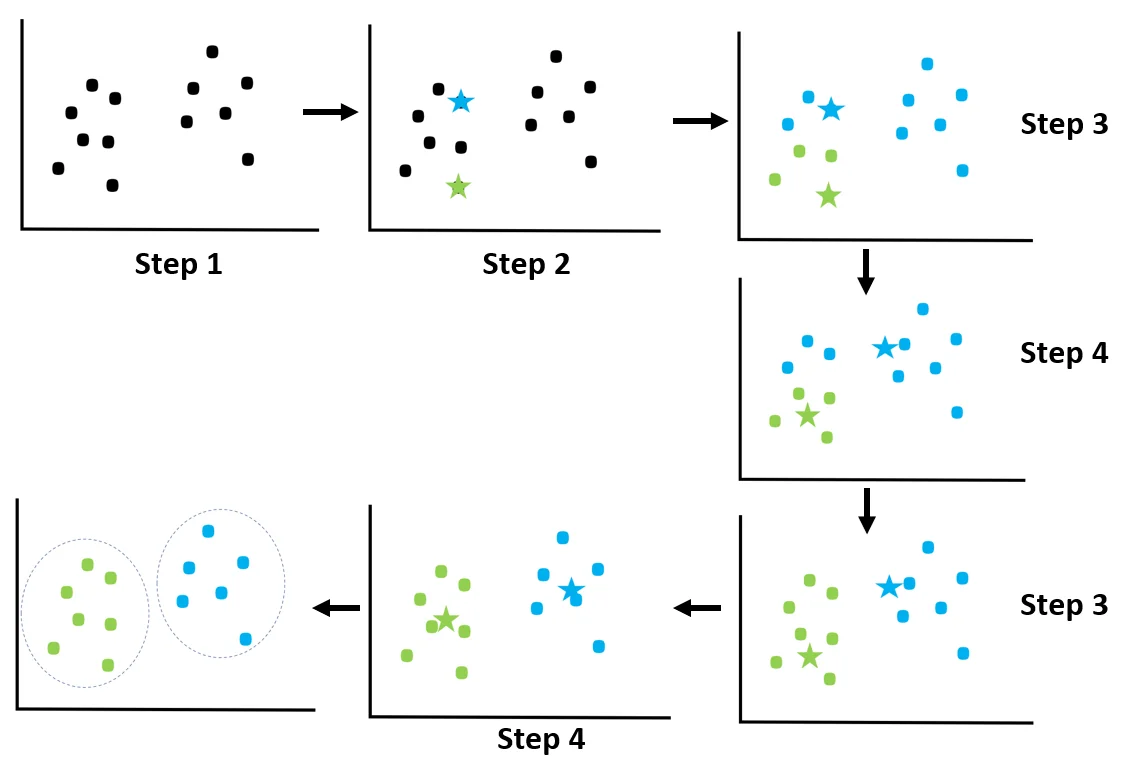
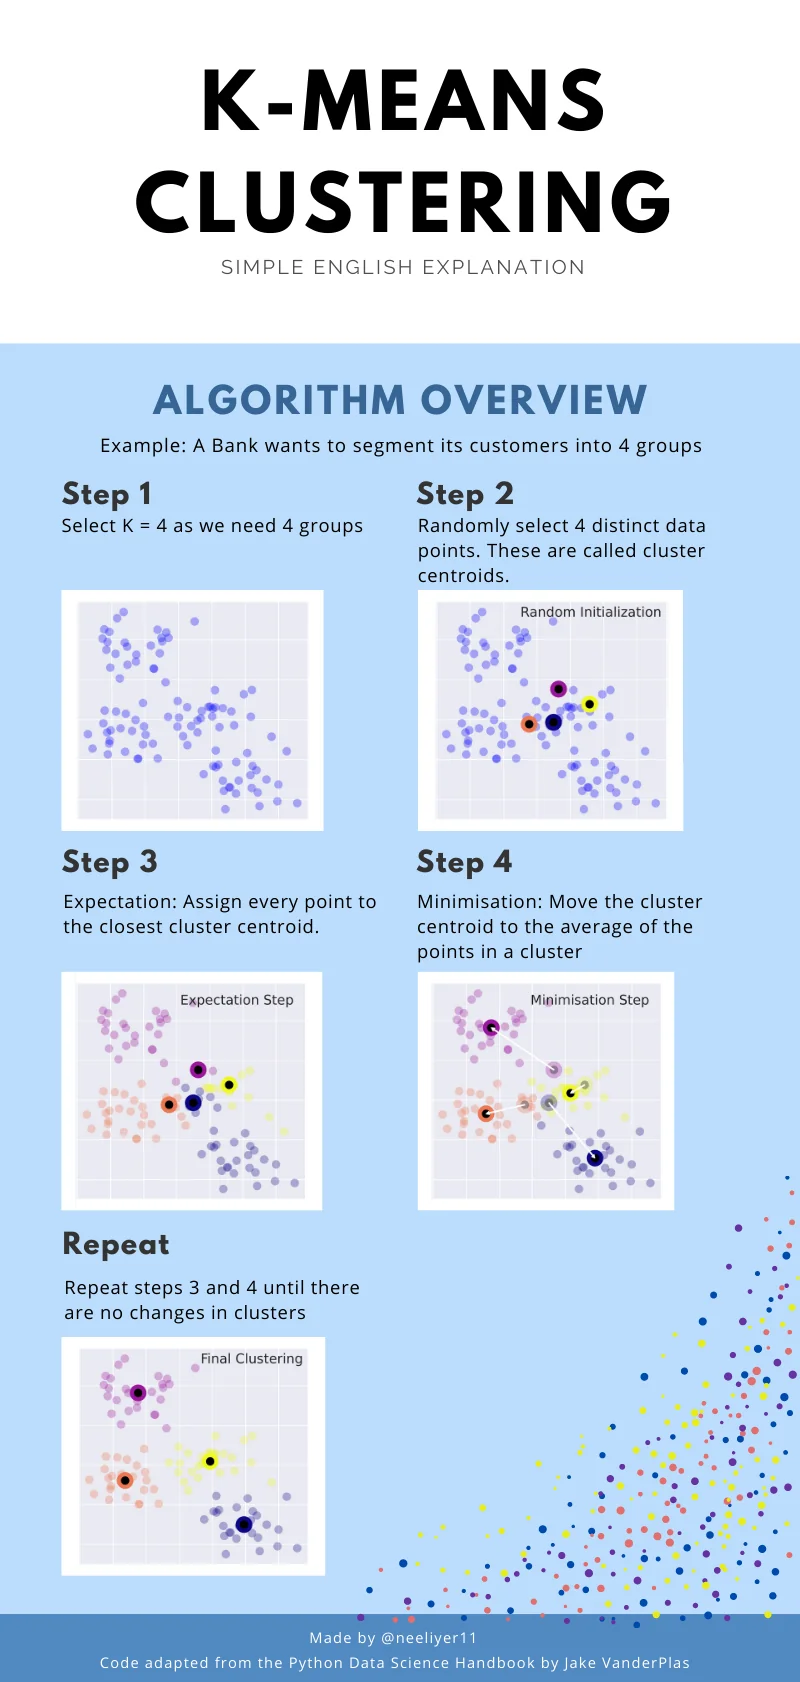
- 1 Inicialización: Seleccionar aleatoriamente $ K $ centroides $ \{c_1, ..., c_K\} $.
2a Asignación de clústeres: Para cada punto de datos $ x_i $, asignarlo al clúster $ k $ cuyo centroide $ c_k $ esté más cercano:
$z_i = \arg \min_{k\in \{1,...,K\}} ||x_i - c_k||^2$
2b Actualización de centroides: Recalcular los centroides como el promedio de los puntos asignados a cada clúster:
$c_k = \frac{1}{|S_k|} \sum_{x_i \in S_k} x_i$
donde $ S_k $ es el conjunto de puntos asignados al clúster $ k $.
- 3 Convergencia: Repetir los pasos 2 y 3 hasta que los centroides dejen de cambiar significativamente.
Importancia de Ejecutar K-Means Múltiples Veces
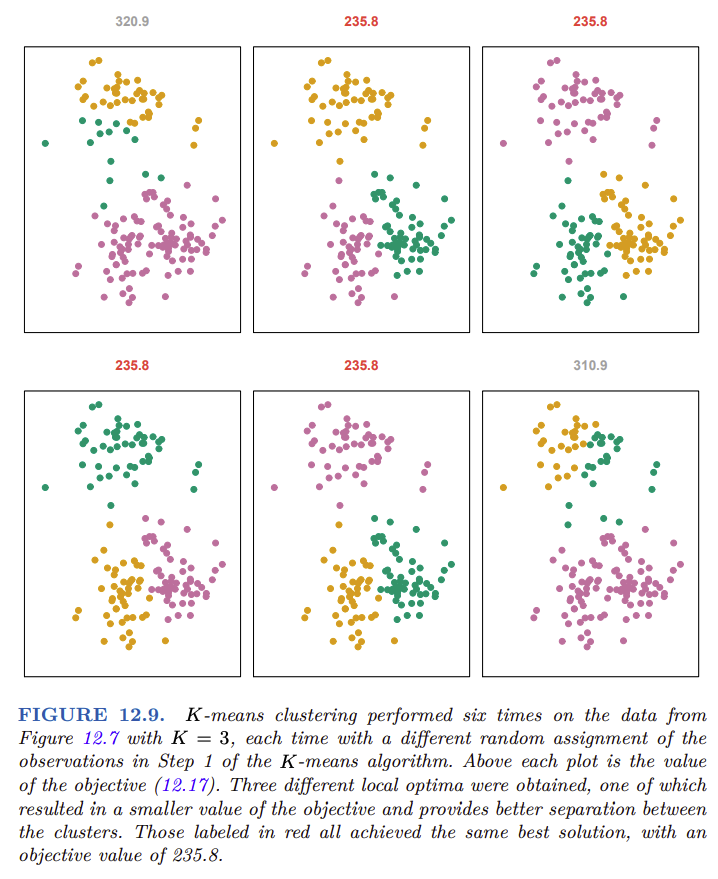
El algoritmo K-Means encuentra un mínimo local, no un óptimo global. Esto significa que los resultados obtenidos dependen fuertemente de la inicialización aleatoria de los centroides en el Paso 1 del algoritmo.
Para mitigar este problema, es crucial ejecutar K-Means múltiples veces con diferentes configuraciones iniciales y seleccionar la mejor solución, es decir, aquella para la cual la función objetivo es mínima:
$J = \sum_{i=1}^{n} \sum_{k=1}^{K} \mathbf{1}(z_i = k) ||x_i - c_k||^2$
donde:
- $ x_i $ es la observación $ i $-ésima.
- $ c_k $ es el centroide del clúster $ k $.
- $ \mathbf{1}(z_i = k) $ es una función indicadora que vale 1 si $ x_i $ pertenece al clúster $ k $ y 0 en caso contrario.
En la Figura 12.9, se observan seis ejecuciones diferentes de K-Means sobre el mismo conjunto de datos de la Figura 12.7. Cada una de estas ejecuciones produce un agrupamiento distinto debido a las diferencias en la inicialización de los centroides. En este caso, el mejor clustering es el que tiene un valor objetivo de 235.8.
¿Cómo mitigar el problema de los mínimos locales?
Para reducir la sensibilidad de K-Means a la inicialización, existen varios enfoques:
Ejecutar K-Means múltiples veces
- Se recomienda repetir el algoritmo con diferentes inicializaciones aleatorias y seleccionar el mejor resultado.
- Implementado en librerías como Scikit-Learn con el parámetro
n_init.
K-Means++ (Mejor Inicialización de Centroides)
- Mejora la selección inicial de centroides, reduciendo la probabilidad de converger a un mínimo local.
- Los centroides iniciales se eligen de forma probabilística, favoreciendo aquellos que maximizan la distancia entre sí.
Usar Métodos de Clustering más Robustas
- Algoritmos como DBSCAN o Clustering Jerárquico pueden ser mejores en ciertos casos, especialmente cuando la estructura de los datos no es esférica.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn import datasets
# Cargar el dataset Iris
iris = datasets.load_iris()
X = iris.data[:, :2] # Tomamos solo las primeras dos características para visualización
# Número de clusters
n_clusters = 3
# Número de inicializaciones
n_init = 20
# Almacenar las inercias de cada inicialización y los modelos
inercias = []
models = []
# Ejecutar KMeans n_init veces y almacenar las inercias y los modelos
for i in range(n_init):
kmeans = KMeans(n_clusters=n_clusters, random_state=i, n_init=1)
kmeans.fit(X)
inercias.append(kmeans.inertia_)
models.append(kmeans)
# Encontrar el índice del mejor modelo (el de menor inercia)
best_index = np.argmin(inercias)
best_model = models[best_index]
# Visualizar las inercias
plt.figure(figsize=(10, 6))
plt.plot(range(1, n_init + 1), inercias, marker='o', linestyle='-')
plt.xlabel('Iteración de n_init')
plt.ylabel('Inercia')
plt.title('Inercia en diferentes iteraciones de n_init')
plt.grid(True)
plt.show()
# Mostrar las inercias
for i, inercia in enumerate(inercias, start=1):
print(f'Iteración {i}: Inercia = {inercia}')
print(f'\nMejor iteración: {best_index + 1} con inercia = {inercias[best_index]}')
# Visualizar los clusters del mejor modelo
plt.figure(figsize=(10, 6))
plt.scatter(X[:, 0], X[:, 1], c=best_model.labels_, cmap='viridis', edgecolor='k')
plt.scatter(best_model.cluster_centers_[:, 0], best_model.cluster_centers_[:, 1], s=300, c='red', marker='X')
plt.xlabel('Longitud del Sépalo')
plt.ylabel('Ancho del Sépalo')
plt.title('Mejor K-Means con n_init=20 en el dataset Iris')
plt.show()


Ejecutar K-Means en Otros Datasets
import numpy as np
import matplotlib.pyplot as plt
# Fijar semilla para reproducibilidad
np.random.seed(42)
# Generar dos clusters gausianos
X1 = np.random.normal(loc=[2, 2], scale=0.5, size=(50, 2)) # Cluster 1
X2 = np.random.normal(loc=[6, 6], scale=0.5, size=(50, 2)) # Cluster 2
# Unir en un solo dataset
X = np.vstack((X1, X2))
# Crear etiquetas de ground truth
y = np.array([0]*50 + [1]*50)
# Visualización
plt.scatter(X[y == 0, 0], X[y == 0, 1], s=50, alpha=0.7, label='Cluster 1')
plt.scatter(X[y == 1, 0], X[y == 1, 1], s=50, alpha=0.7, label='Cluster 2')
plt.title("Dos Clusters Gaussianos")
plt.legend()
plt.show()

from sklearn import datasets
import pandas as pd
import matplotlib.pyplot as plt
# Cargar datos de Iris
iris = datasets.load_iris()
X = iris.data
y = iris.target
# Convertir a DataFrame para mejor interpretación
df = pd.DataFrame(X, columns=iris.feature_names)
# Visualización de las dos primeras características con etiquetas de ground truth
plt.scatter(df.iloc[y == 0, 0], df.iloc[y == 0, 1], s=50, alpha=0.7, label=iris.target_names[0])
plt.scatter(df.iloc[y == 1, 0], df.iloc[y == 1, 1], s=50, alpha=0.7, label=iris.target_names[1])
plt.scatter(df.iloc[y == 2, 0], df.iloc[y == 2, 1], s=50, alpha=0.7, label=iris.target_names[2])
plt.xlabel(iris.feature_names[0])
plt.ylabel(iris.feature_names[1])
plt.title("Iris Dataset - Visualización con etiquetas de ground truth")
plt.legend()
plt.show()

from sklearn.datasets import make_circles
import matplotlib.pyplot as plt
# Generar dataset de anillos concéntricos
X, y = make_circles(n_samples=300, factor=0.5, noise=0.05)
# Visualización con etiquetas de ground truth
plt.scatter(X[y == 0, 0], X[y == 0, 1], s=50, alpha=0.7, label='Cluster 1')
plt.scatter(X[y == 1, 0], X[y == 1, 1], s=50, alpha=0.7, label='Cluster 2')
plt.title("Anillos Concéntricos - make_circles")
plt.legend()
plt.show()

from sklearn.datasets import make_moons
import matplotlib.pyplot as plt
# Generar dataset de lunas
X, y = make_moons(n_samples=300, noise=0.05)
# Visualización con etiquetas de ground truth
plt.scatter(X[y == 0, 0], X[y == 0, 1], s=50, alpha=0.7, label='Cluster 1')
plt.scatter(X[y == 1, 0], X[y == 1, 1], s=50, alpha=0.7, label='Cluster 2')
plt.title("Lunas Entrelazadas - make_moons")
plt.legend()
plt.show()

import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Cargar el dataset "penguins" desde seaborn
df = sns.load_dataset('penguins')
# Mostrar las primeras filas del dataset
print(df.head())
# Eliminar filas con valores nulos
df = df.dropna()
# Visualización de los clusters utilizando las especies como ground truth
species = df['species'].unique()
colors = ['r', 'g', 'b']
for species, color in zip(species, colors):
subset = df[df['species'] == species]
plt.scatter(subset['bill_length_mm'], subset['bill_depth_mm'], s=50, alpha=0.7, label=species, c=color)
plt.xlabel("Longitud del Pico (mm)")
plt.ylabel("Profundidad del Pico (mm)")
plt.title("Segmentación de Pingüinos por Especie")
plt.legend()
plt.show()

import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
# Cargar el dataset de vinos
wine = load_wine()
X_wine = wine.data[:, :2] # Tomamos solo las primeras dos características para visualización
y_wine = wine.target # Etiquetas de las clases
# Crear un DataFrame con las características y las etiquetas
df = pd.DataFrame(X_wine, columns=['Alcohol', 'Malic Acid'])
df['Class'] = y_wine
# Obtener los nombres de las clases
class_names = wine.target_names
# Visualización de los puntos con el ground truth de clusters
colors = ['r', 'g', 'b']
for class_label, color in zip(range(len(class_names)), colors):
subset = df[df['Class'] == class_label]
plt.scatter(subset['Alcohol'], subset['Malic Acid'], s=50, alpha=0.7, label=class_names[class_label], c=color)
plt.xlabel("Alcohol")
plt.ylabel("Ácido Málico")
plt.title("Vinos")
plt.legend()
plt.show()

import random
random.seed(42)
# Importar librerías necesarias
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
from sklearn.cluster import KMeans
from sklearn import datasets
from sklearn.datasets import make_circles, make_moons
import seaborn as sns
# Fijar semilla para reproducibilidad
np.random.seed(42)
# Crear una lista para almacenar los datasets y sus nombres
datasets_dict = {}
# 1️ Dataset Sintético: Dos Clusters Gaussianos
X1 = np.random.normal(loc=[2, 2], scale=0.5, size=(50, 2)) # Cluster 1
X2 = np.random.normal(loc=[6, 6], scale=0.5, size=(50, 2)) # Cluster 2
X_gaussians = np.vstack((X1, X2))
y_gaussians = np.array([0]*50 + [1]*50)
datasets_dict["Clusters Gaussianos"] = (X_gaussians, y_gaussians, 2)
# 2️ Dataset Clásico: Iris Dataset
iris = datasets.load_iris()
X_iris = iris.data[:, :2] # Tomamos solo las primeras dos características para visualización
y_iris = iris.target
datasets_dict["Iris Dataset"] = (X_iris, y_iris, 3)
# 3️ Dataset Sintético: Anillos Concéntricos
X_circles, y_circles = make_circles(n_samples=300, factor=0.5, noise=0.05)
datasets_dict["Anillos Concéntricos"] = (X_circles, y_circles, 2)
# 4️ Dataset Sintético: Lunas Entrelazadas
X_moons, y_moons = make_moons(n_samples=300, noise=0.05)
datasets_dict["Lunas Entrelazadas"] = (X_moons, y_moons, 2)
# 5️ Dataset Real: Pingüinos
df_penguins = sns.load_dataset('penguins').dropna()
X_penguins = df_penguins[['bill_length_mm', 'bill_depth_mm']].values
y_penguins = df_penguins['species'].astype('category').cat.codes.values
datasets_dict["Pingüinos"] = (X_penguins, y_penguins, 3)
# Cargar un dataset real pequeño: Datos de vinos de sklearn
from sklearn.datasets import load_wine
# Cargar el dataset
wine = load_wine()
X_wine = wine.data[:, :2] # Tomamos solo las primeras dos características para visualización
y_wine = wine.target
datasets_dict["Vinos (Wine Dataset)"] = (X_wine, y_wine, 3)
# Visualizar los datasets incluyendo el de pingüinos
fig, axes = plt.subplots(len(datasets_dict), 2, figsize=(12, 5 * len(datasets_dict)))
axes = axes.flatten()
for i, (name, (X, y, n_clusters)) in enumerate(datasets_dict.items()):
# K-means clustering
kmeans = KMeans(n_clusters=n_clusters, n_init=20)#random_state=42,
kmeans.fit(X)
labels = kmeans.labels_
# Plot K-means result
scatter = axes[2*i].scatter(X[:, 0], X[:, 1], c=labels, cmap='viridis', edgecolor='k')
axes[2*i].set_title(f"K-Means en {name}")
axes[2*i].text(0.95, 0.95, f"Número real de clusters: {n_clusters}",
horizontalalignment='right',
verticalalignment='top',
transform=axes[2*i].transAxes,
bbox=dict(facecolor='white', alpha=0.6))
# Plot ground truth
scatter = axes[2*i + 1].scatter(X[:, 0], X[:, 1], c=y, cmap='viridis', edgecolor='k')
axes[2*i + 1].set_title(f"Ground Truth en {name}")
axes[2*i + 1].text(0.95, 0.95, f"Número real de clusters: {n_clusters}",
horizontalalignment='right',
verticalalignment='top',
transform=axes[2*i + 1].transAxes,
bbox=dict(facecolor='white', alpha=0.6))
if name == "Pingüinos":
axes[2*i].set_xlabel('Longitud del Pico (mm)')
axes[2*i].set_ylabel('Profundidad del Pico (mm)')
axes[2*i + 1].set_xlabel('Longitud del Pico (mm)')
axes[2*i + 1].set_ylabel('Profundidad del Pico (mm)')
elif name == "Vinos (Wine Dataset)":
axes[2*i].set_xlabel('Alcohol')
axes[2*i].set_ylabel('Ácido Málico')
axes[2*i + 1].set_xlabel('Alcohol')
axes[2*i + 1].set_ylabel('Ácido Málico')
elif name == "Iris Dataset":
axes[2*i].set_xlabel('Longitud del Sépalo')
axes[2*i].set_ylabel('Ancho del Sépalo')
axes[2*i + 1].set_xlabel('Longitud del Sépalo')
axes[2*i + 1].set_ylabel('Ancho del Sépalo')
else:
axes[2*i].set_xlabel('Característica 1')
axes[2*i].set_ylabel('Característica 2')
axes[2*i + 1].set_xlabel('Característica 1')
axes[2*i + 1].set_ylabel('Característica 2')
# Ajustar diseño
plt.tight_layout()
plt.show()

Si no tenemos el "ground truth" ¿cómo sabemos cuántos clusters ejecutar?
Evaluación de Clustering: Método del Codo y Silhouette Score
Método del Codo
Definición
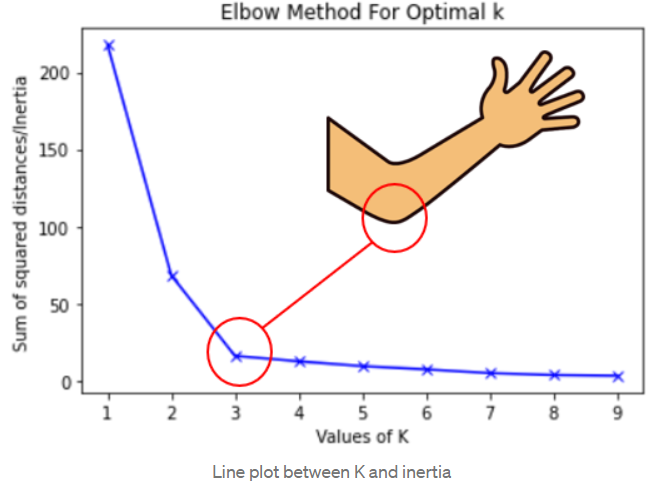
El método del codo es una técnica visual utilizada para determinar el número óptimo de clusters en K-Means. Se basa en la inercia intra-cluster, que mide la dispersión de los puntos dentro de sus respectivos clusters.
Matemáticamente, la inercia se define como:
$\text{Inercia} = \sum_{k=1}^{K} \sum_{i \in C_k} \|X_i - \mu_k\|^2$
donde:
- $ K $ es el número de clusters.
- $ C_k $ representa el conjunto de puntos en el cluster $ k $.
- $ \mu_k $ es el centroide del cluster $ C_k $.
- $ \|X_i - \mu_k\|^2 $ es la distancia euclidiana al centroide.
Interpretación
- Se calcula la inercia para diferentes valores de $ K $.
- Se grafica $ K $ vs. Inercia.
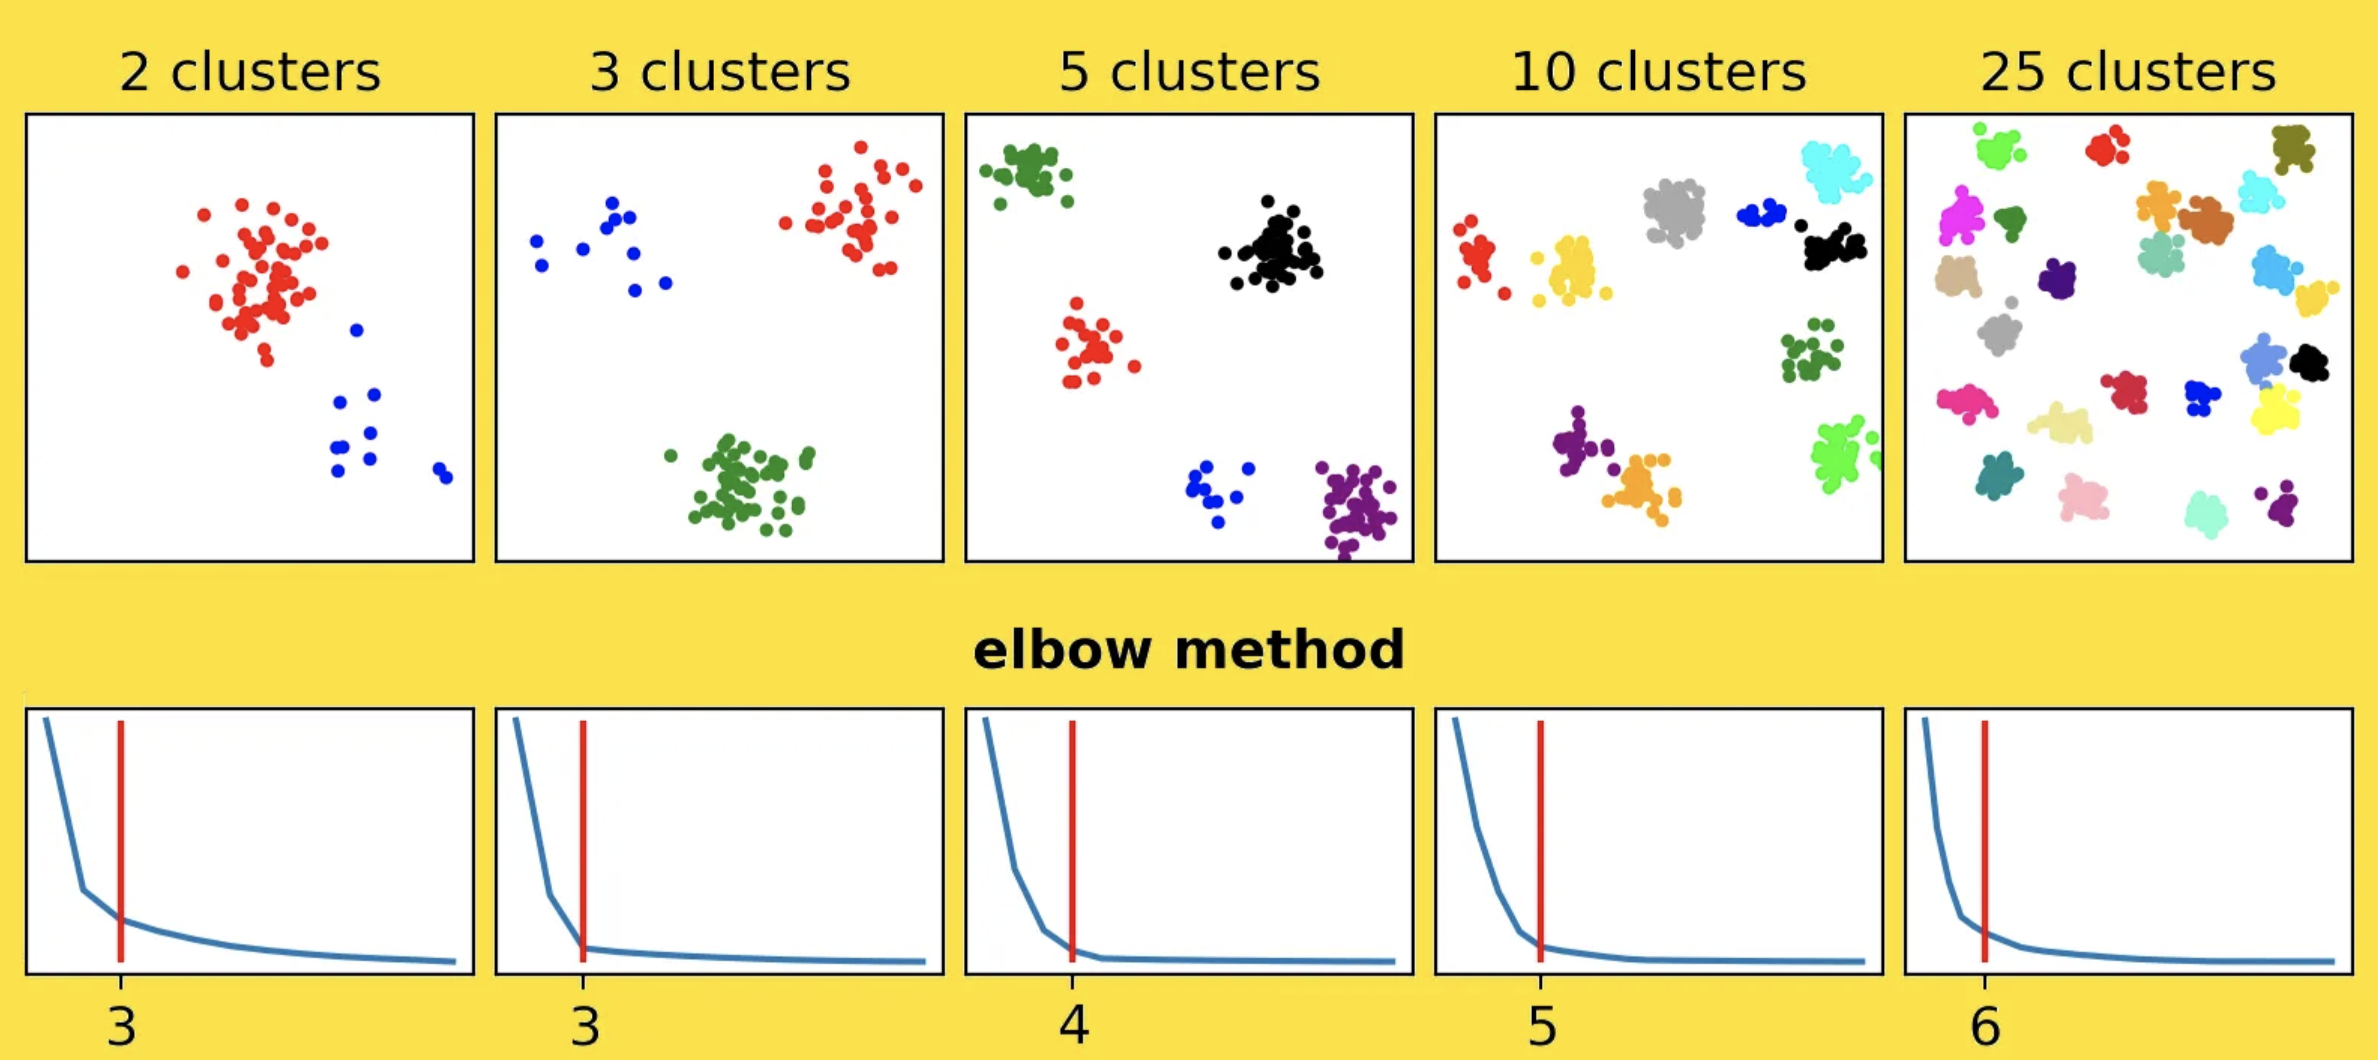
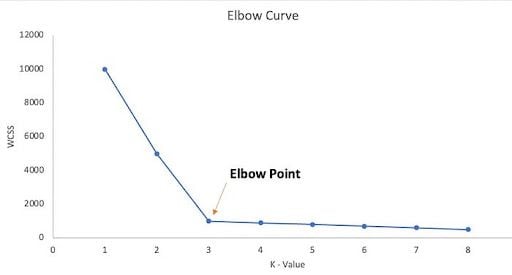
- El punto donde la pendiente comienza a disminuir significativamente es el "codo", que representa el número óptimo de clusters.
Ejemplo de Gráfica
Un ejemplo típico del método del codo muestra una curva decreciente con un punto de inflexión, donde la ganancia por agregar más clusters se reduce:
Silhouette Score
Definición
El Silhouette Score es una métrica que evalúa la calidad de un clustering midiendo qué tan bien cada punto está agrupado con su propio cluster y separado de otros clusters. Se define para cada punto $ i $ como:
$s(i) = \frac{b(i) - a(i)}{\max(a(i), b(i))}$
donde:
- $ a(i) $ es la distancia promedio de $ i $ a los otros puntos dentro de su cluster.
$ b(i) $ La distancia promedio de $i$ a todos los puntos del cluster más cercano al que no pertenece.
El valor de $ s(i) $ está en el rango $[-1, 1]$.
Interpretación
- $ s(i) \approx 1 $: El punto está bien asignado a su cluster.
- $ s(i) \approx 0 $: El punto está en el límite entre dos clusters.
- $ s(i) < 0 $: El punto está mal asignado y probablemente debería estar en otro cluster.
Cómo utilizarlo
- Se calcula el promedio de $ s(i) $ para todos los puntos, obteniendo un Silhouette Score global.
- Un mayor Silhouette Score indica una mejor partición de los datos.
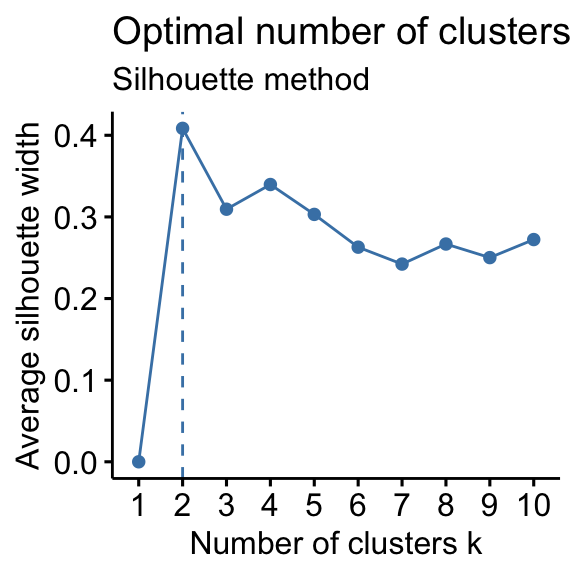
Ejemplo de Gráfica
La gráfica típica del Silhouette Score muestra su valor en función de $ K $, ayudando a elegir el número óptimo de clusters:
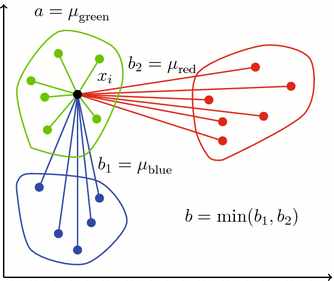
La figura muestra el cálculo del Silhouette de un punto específico (x_i) (el punto negro), comparándolo con los clústeres de colores.
1) Qué es (a) (cohesión intra-clúster)
(x_i) está asignado al clúster verde. Entonces:
$a(i)=\frac{1}{|C_{\text{green}}|-1}\sum_{x_j\in C_{\text{green}}, j\neq i} d(x_i,x_j)$
En el dibujo aparece como ($a=\mu_{\text{green}}$): el promedio de las distancias (líneas verdes) desde ($x_i$) a los otros puntos del mismo clúster.
- Pequeño (a(i)) entonces ($x_i$) está bien "metido" dentro del clúster.
2) Qué es (b) (separación hacia el clúster vecino)
Para cada otro clúster, calculas el promedio de distancias desde (x_i) hacia ese clúster:
$b_{k}(i)=\frac{1}{|C_k|}\sum_{x_j\in C_k} d(x_i,x_j)$
En el dibujo:
- ($b_1=\mu_{\text{blue}}$) (promedio hacia el clúster azul)
- ($b_2=\mu_{\text{red}}$) (promedio hacia el clúster rojo)
Luego tomas el más cercano en promedio (el “clúster vecino”):
$b(i)=\min_{k\neq \text{green}} b_k(i)$
Por eso en la imagen dice ($b=\min(b_1,b_2)$).
- Grande (b(i)) ⇒ los otros clústeres están lejos de ($x_i$).
3) Silhouette del punto ($x_i$)
Con esos dos números:
$s(i)=\frac{b(i)-a(i)}{\max{a(i),,b(i)}}\qquad\in[-1,1]$
Interpretación:
- ($s(i)\approx 1$): (a) pequeño y (b) grande ⇒ bien asignado y bien separado.
- ($s(i)\approx 0$): está cerca de la frontera entre clústeres (($a\approx b$)).
- ($s(i)<0$): ($a>b$) ⇒ está más cerca (en promedio) de otro clúster que del suyo entonces probable mala asignación.
4) Cómo se usa para elegir (K)
Para cada (K), calculas el promedio:
$S(K)=\frac{1}{n}\sum_{i=1}^n s(i)$
y sueles elegir el (K) que maximiza (S(K)) (o donde (S(K)) es alto y estable).
Comparación entre ambos métodos
| Método | ¿Qué mide? | ¿Cómo se usa? |
|---|---|---|
| Método del Codo | Dispersión dentro de los clusters (inercia) | Buscar el "codo" en la curva de inercia |
| Silhouette Score | Separación entre clusters y compactación interna | Elegir el $ K $ con mayor Silhouette Score |
Conclusión:
- El Método del Codo es útil para determinar cuándo dejar de agregar más clusters.
- El Silhouette Score ayuda a evaluar qué tan bien están formados los clusters.
Usar ambos métodos juntos permite una mejor elección del número de clusters en K-Means.
# Importar librerías necesarias
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
from sklearn.cluster import KMeans
from sklearn import datasets
from sklearn.datasets import make_circles, make_moons
import seaborn as sns
from sklearn.metrics import silhouette_score
# Fijar semilla para reproducibilidad
np.random.seed(42)
# Crear una lista para almacenar los datasets y sus nombres
datasets_dict = {}
# 1️ Dataset Sintético: Dos Clusters Gaussianos
X1 = np.random.normal(loc=[2, 2], scale=0.5, size=(50, 2)) # Cluster 1
X2 = np.random.normal(loc=[6, 6], scale=0.5, size=(50, 2)) # Cluster 2
X_gaussians = np.vstack((X1, X2))
y_gaussians = np.array([0]*50 + [1]*50)
datasets_dict["Clusters Gaussianos"] = (X_gaussians, y_gaussians, 2)
# 2️ Dataset Clásico: Iris Dataset
iris = datasets.load_iris()
X_iris = iris.data[:, :2] # Tomamos solo las primeras dos características para visualización
y_iris = iris.target
datasets_dict["Iris Dataset"] = (X_iris, y_iris, 3)
# 3️ Dataset Sintético: Anillos Concéntricos
X_circles, y_circles = make_circles(n_samples=300, factor=0.5, noise=0.05)
datasets_dict["Anillos Concéntricos"] = (X_circles, y_circles, 2)
# 4️ Dataset Sintético: Lunas Entrelazadas
X_moons, y_moons = make_moons(n_samples=300, noise=0.05)
datasets_dict["Lunas Entrelazadas"] = (X_moons, y_moons, 2)
# 5️ Dataset Real: Pingüinos
df_penguins = sns.load_dataset('penguins').dropna()
X_penguins = df_penguins[['bill_length_mm', 'bill_depth_mm']].values
y_penguins = df_penguins['species'].astype('category').cat.codes.values
datasets_dict["Pingüinos"] = (X_penguins, y_penguins, 3)
# Cargar un dataset real pequeño: Datos de vinos de sklearn
from sklearn.datasets import load_wine
# Cargar el dataset
wine = load_wine()
X_wine = wine.data[:, :2] # Tomamos solo las primeras dos características para visualización
y_wine = wine.target
datasets_dict["Vinos (Wine Dataset)"] = (X_wine, y_wine, 3)
# Función para calcular el método del codo y la puntuación de Silhouette
def analizar_num_clusters(X, max_k=6):
inertias = []
silhouette_scores = []
K_values = range(1, max_k+1) # Empezar desde 1 cluster
for k in K_values:
kmeans = KMeans(n_clusters=k, random_state=42, n_init=20)
labels = kmeans.fit_predict(X)
# Inercia (método del codo)
inertias.append(kmeans.inertia_)
# Puntuación de Silhouette (si hay más de un cluster)
if k > 1:
silhouette_scores.append(silhouette_score(X, labels))
else:
silhouette_scores.append(0)
return K_values, inertias, silhouette_scores
# Aplicar análisis en todos los datasets
fig, axes = plt.subplots(len(datasets_dict), 4, figsize=(24, 5 * len(datasets_dict)))
axes = axes.flatten()
for i, (name, (X, y, n_clusters)) in enumerate(datasets_dict.items()):
K_values, inertias, silhouette_scores = analizar_num_clusters(X, max_k=6)
# Gráfico del método del codo
axes[4*i].plot(K_values, inertias, marker='o', linestyle='-')
axes[4*i].set_title(f"Método del Codo - {name}")
axes[4*i].set_xlabel("Número de Clusters (K)")
axes[4*i].set_ylabel("Inercia")
axes[4*i].text(0.95, 0.95, f"Número real de clusters: {n_clusters}",
horizontalalignment='right',
verticalalignment='top',
transform=axes[4*i].transAxes,
bbox=dict(facecolor='white', alpha=0.6))
# Gráfico del Silhouette Score
axes[4*i+1].plot(K_values, silhouette_scores, marker='o', linestyle='-')
axes[4*i+1].set_title(f"Silhouette Score - {name}")
axes[4*i+1].set_xlabel("Número de Clusters (K)")
axes[4*i+1].set_ylabel("Puntuación Silhouette")
axes[4*i+1].text(0.95, 0.95, f"Número real de clusters: {n_clusters}",
horizontalalignment='right',
verticalalignment='top',
transform=axes[4*i+1].transAxes,
bbox=dict(facecolor='white', alpha=0.6))
# K-means clustering
kmeans = KMeans(n_clusters=n_clusters, random_state=42, n_init=20)
kmeans.fit(X)
labels = kmeans.labels_
# Plot K-means result
scatter = axes[4*i+2].scatter(X[:, 0], X[:, 1], c=labels, cmap='viridis', edgecolor='k')
axes[4*i+2].set_title(f"K-Means en {name}")
axes[4*i+2].text(0.95, 0.95, f"Número real de clusters: {n_clusters}",
horizontalalignment='right',
verticalalignment='top',
transform=axes[4*i+2].transAxes,
bbox=dict(facecolor='white', alpha=0.6))
# Plot ground truth
scatter = axes[4*i+3].scatter(X[:, 0], X[:, 1], c=y, cmap='viridis', edgecolor='k')
axes[4*i+3].set_title(f"Ground Truth en {name}")
axes[4*i+3].text(0.95, 0.95, f"Número real de clusters: {n_clusters}",
horizontalalignment='right',
verticalalignment='top',
transform=axes[4*i+3].transAxes,
bbox=dict(facecolor='white', alpha=0.6))
if name == "Pingüinos":
axes[4*i+2].set_xlabel('Longitud del Pico (mm)')
axes[4*i+2].set_ylabel('Profundidad del Pico (mm)')
axes[4*i+3].set_xlabel('Longitud del Pico (mm)')
axes[4*i+3].set_ylabel('Profundidad del Pico (mm)')
elif name == "Vinos (Wine Dataset)":
axes[4*i+2].set_xlabel('Alcohol')
axes[4*i+2].set_ylabel('Ácido Málico')
axes[4*i+3].set_xlabel('Alcohol')
axes[4*i+3].set_ylabel('Ácido Málico')
elif name == "Iris Dataset":
axes[4*i+2].set_xlabel('Longitud del Sépalo')
axes[4*i+2].set_ylabel('Ancho del Sépalo')
axes[4*i+3].set_xlabel('Longitud del Sépalo')
axes[4*i+3].set_ylabel('Ancho del Sépalo')
else:
axes[4*i+2].set_xlabel('Característica 1')
axes[4*i+2].set_ylabel('Característica 2')
axes[4*i+3].set_xlabel('Característica 1')
axes[4*i+3].set_ylabel('Característica 2')
# Ajustar diseño
plt.tight_layout()
plt.show()

Problemas del Método del Codo y del Silhouette Score
1. Problemas del Método del Codo
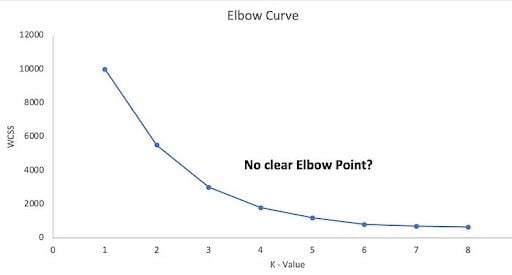
1.1 No siempre hay un "codo" claro
El método del codo se basa en encontrar un punto de inflexión en la gráfica de inercia, pero en algunos datasets la curva es suave y sin un codo evidente, lo que dificulta la selección del número óptimo de clusters.
Ejemplo:
- Si la inercia disminuye gradualmente sin un punto de cambio claro, la elección de $ K $ se vuelve subjetiva.
Ejemplo: gráfico sin codo claro
1.2 Sensible a la escala de los datos
- Si los datos no están bien escalados, la inercia puede estar dominada por variables con valores más grandes.
- Solución: Normalizar los datos antes de aplicar K-means.
1.3 No evalúa la separación de clusters
El método del codo solo mide compactación interna (inercia), pero no indica si los clusters están bien separados entre sí.
Ejemplo:
- Dos clusters pueden ser compactos pero estar muy cerca el uno del otro, lo que genera mala separación.
Conclusión:
El método del codo es útil pero subjetivo. Debe complementarse con otro método como el Silhouette Score.
2. Problemas del Silhouette Score
2.1 Favorece valores bajos de $ K $
El Silhouette Score suele favorecer valores bajos de $ K $, ya que a mayor número de clusters, los puntos están más cerca de su propio cluster, incluso si la segmentación no es útil.
Ejemplo:
- Si $ K=4 $ da un Silhouette Score de 0.51 y $ K=7 $ da 0.49, pero los clusters de $ K=7 $ tienen más sentido, elegir $ K=4 $ sería un error.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score
# Fijar semilla para reproducibilidad
np.random.seed(42)
# Generar siete clusters gausianos
X1 = np.random.normal(loc=[2, 2], scale=.8, size=(50, 2)) # Cluster 1
X2 = np.random.normal(loc=[6, 6], scale=.8, size=(50, 2)) # Cluster 2
X3 = np.random.normal(loc=[2, 6], scale=.8, size=(50, 2)) # Cluster 3
X4 = np.random.normal(loc=[6, 2], scale=.8, size=(50, 2)) # Cluster 4
X5 = np.random.normal(loc=[4, 4], scale=.8, size=(50, 2)) # Cluster 5
X6 = np.random.normal(loc=[8, 8], scale=.8, size=(50, 2)) # Cluster 6
X7 = np.random.normal(loc=[0, 0], scale=.8, size=(50, 2)) # Cluster 7
# X43 = np.random.normal(loc=[4, 10], scale=1.9, size=(50, 2)) # Cluster 4
# X53 = np.random.normal(loc=[4, 0], scale=1.9, size=(50, 2)) # Cluster 5
# X63 = np.random.normal(loc=[9, -2], scale=1.9, size=(50, 2)) # Cluster 6
# X73 = np.random.normal(loc=[-2, 10], scale=1.9, size=(50, 2)) # Cluster 7
# Unir en un solo dataset
X = np.vstack((X1, X2, X3, X4, X5, X6, X7)) #,X43,X53,X63,X73))
# Crear etiquetas de ground truth
y = np.array([0]*50 + [1]*50 + [2]*50 + [3]*50 + [4]*50 + [5]*50 + [6]*50) #. + [7]*50) # + [8]*50 + [9]*50 + [10]*50)
# Visualización
plt.scatter(X[y == 0, 0], X[y == 0, 1], s=50, alpha=0.7, label='Cluster 1')
plt.scatter(X[y == 1, 0], X[y == 1, 1], s=50, alpha=0.7, label='Cluster 2')
plt.scatter(X[y == 2, 0], X[y == 2, 1], s=50, alpha=0.7, label='Cluster 3')
plt.scatter(X[y == 3, 0], X[y == 3, 1], s=50, alpha=0.7, label='Cluster 4')
plt.scatter(X[y == 4, 0], X[y == 4, 1], s=50, alpha=0.7, label='Cluster 5')
plt.scatter(X[y == 5, 0], X[y == 5, 1], s=50, alpha=0.7, label='Cluster 6')
plt.scatter(X[y == 6, 0], X[y == 6, 1], s=50, alpha=0.7, label='Cluster 7')
# plt.scatter(X[y == 7, 0], X[y == 7, 1], s=50, alpha=0.7, label='Cluster 7')
# plt.scatter(X[y == 8, 0], X[y == 8, 1], s=50, alpha=0.7, label='Cluster 7')
# plt.scatter(X[y == 9, 0], X[y == 9, 1], s=50, alpha=0.7, label='Cluster 7')
# plt.scatter(X[y == 10, 0], X[y == 10, 1], s=50, alpha=0.7, label='Cluster 7')
plt.title("Siete Clusters Gaussianos")
plt.legend()
plt.show()
# Calcular el silhouette score para diferentes números de clusters
silhouette_scores = []
range_n_clusters = range(2, 11) # No tiene sentido calcular silhouette score para 1 cluster
for n_clusters in range_n_clusters:
kmeans = KMeans(n_clusters=n_clusters, random_state=42)
cluster_labels = kmeans.fit_predict(X)
sil_score = silhouette_score(X, cluster_labels)
silhouette_scores.append(sil_score)
# Plotear la curva de silhouette scores
plt.plot(range_n_clusters, silhouette_scores, marker='o')
plt.title("Silhouette Scores para Diferentes Números de Clusters")
plt.xlabel("Número de Clusters")
plt.ylabel("Silhouette Score")
plt.xticks(range_n_clusters)
plt.grid(True)
plt.show()


2.2 No funciona bien en clusters de formas no convexas
El Silhouette Score asume que los clusters tienen forma esférica. Si los clusters tienen formas complejas como lunas o anillos concéntricos, el puntaje puede ser engañoso.
Ejemplo:
- En el dataset de anillos concéntricos, K-Means fallará, pero el Silhouette Score puede indicar que un $ K $ es "óptimo" aunque no tenga sentido.
2.3 Computacionalmente costoso
- Requiere calcular distancias entre todos los puntos y clusters, lo cual es costoso en datasets grandes.
- Alternativa: Para grandes volúmenes de datos, se pueden tomar muestras aleatorias en lugar de usar todos los puntos.
Comparación de Problemas
| Método | Problemas principales |
|---|---|
| Método del Codo | No siempre hay un codo claro, depende de la escala, no mide separación de clusters |
| Silhouette Score | Favorece pocos clusters, no funciona bien en formas no convexas, es costoso computacionalmente, depende de la escala |
Conclusión
- El Método del Codo es útil, pero subjetivo. No siempre hay un codo claro y no mide separación de clusters.
- El Silhouette Score ayuda a medir separación, pero favorece $ K $ pequeños y falla en estructuras no esféricas.
- Lo mejor es usar ambos métodos juntos y complementar con interpretación visual.
Limitaciones del Algoritmo K-Means
a) Sensibilidad a la inicialización
Si los centroides iniciales no son elegidos adecuadamente, K-Means puede converger a soluciones subóptimas. Un método para mitigar esto es la inicialización K-Means++, que selecciona los centroides de manera más informada.
Cómo funciona el algoritmo K-Means++
El algoritmo K-Means++ mejora la inicialización de los centroides en K-Means estándar mediante una selección probabilística que favorece la dispersión de los centros iniciales. Esto ayuda a evitar convergencias a mínimos locales deficientes.
1. Paso de Inicialización
El procedimiento de inicialización sigue los siguientes pasos:
Seleccionar el primer centro aleatorio:
- Se elige el primer centro $ c_1 $ de forma aleatoria de entre todos los puntos del conjunto de datos $ X $.
Seleccionar los siguientes centros de manera probabilística:
- Para cada nuevo centro $ c_i $, se selecciona un punto $ x \in X $ con una probabilidad proporcional al cuadrado de su distancia al centro más cercano ya seleccionado.
Formalmente, si ya hemos seleccionado los centros $ c_1, c_2, ..., c_{i-1} $, definimos la distancia mínima de un punto $ x $ a estos centros como:
$D(x) = \min_{j \in \{1, ..., i-1\}} \| x - c_j \|^2$
Luego, la probabilidad de seleccionar un nuevo punto $ x $ como el próximo centro $ c_i $ es:
$P(x) = \frac{D(x)}{\sum_{x' \in X} D(x')}$
Esto significa que los puntos más alejados de los centros ya seleccionados tienen una mayor probabilidad de ser elegidos.
Ventajas de K-Means++
El uso de esta inicialización permite que los centroides comiencen en posiciones mejor distribuidas, lo que:
- Mejora la convergencia del algoritmo.
- Reduce la probabilidad de quedar atrapado en un mínimo local subóptimo.
- Generalmente disminuye el número de iteraciones necesarias para alcanzar un clustering estable.
Este proceso garantiza que la distribución inicial de los centros de los clusters sea más representativa de la estructura real de los datos, lo que suele llevar a una mejor partición final.
# Ejemplo inicialización k-means++
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import sys
# Definir la media y la covarianza para la primera distribución gaussiana
mean_01 = np.array([0.0, 0.0])
cov_01 = np.array([[1, 0.3], [0.3, 1]])
# Generar 100 puntos de datos para la primera distribución gaussiana
dist_01 = np.random.multivariate_normal(mean_01, cov_01, 100)
# Definir la media y la covarianza para la segunda distribución gaussiana
mean_02 = np.array([6.0, 7.0])
cov_02 = np.array([[1.5, 0.3], [0.3, 1]])
# Generar 100 puntos de datos para la segunda distribución gaussiana
dist_02 = np.random.multivariate_normal(mean_02, cov_02, 100)
# Definir la media y la covarianza para la tercera distribución gaussiana
mean_03 = np.array([7.0, -5.0])
cov_03 = np.array([[1.2, 0.5], [0.5, 1]])
# Generar 100 puntos de datos para la tercera distribución gaussiana
dist_03 = np.random.multivariate_normal(mean_03, cov_01, 100)
# Definir la media y la covarianza para la cuarta distribución gaussiana
mean_04 = np.array([2.0, -7.0])
cov_04 = np.array([[1.2, 0.5], [0.5, 1.3]])
# Generar 100 puntos de datos para la cuarta distribución gaussiana
dist_04 = np.random.multivariate_normal(mean_04, cov_01, 100)
# Combinar todas las distribuciones en un solo conjunto de datos
data = np.vstack((dist_01, dist_02, dist_03, dist_04))
# Mezclar aleatoriamente los datos
np.random.shuffle(data)
# Función para graficar los datos y los centroides
def plot(data, centroids):
plt.scatter(data[:, 0], data[:, 1], marker='.', color='gray', label='data points')
plt.scatter(centroids[:-1, 0], centroids[:-1, 1], color='black', label='previously selected centroids')
plt.scatter(centroids[-1, 0], centroids[-1, 1], color='red', label='next centroid')
plt.title('Select % d th centroid' % (centroids.shape[0]))
plt.legend()
plt.xlim(-5, 12)
plt.ylim(-10, 15)
plt.show()
# Función para calcular la distancia euclidiana entre dos puntos
def distance(p1, p2):
return np.sqrt(np.sum((p1 - p2)**2))
# Algoritmo de inicialización k-means++
def initialize(data, k):
'''
Inicializa los centroides para K-means++
Entradas:
data - array de numpy con los puntos de datos de forma (200, 2)
k - número de clusters
'''
centroids = []
# Seleccionar el primer centroide aleatoriamente de los datos
centroids.append(data[np.random.randint(data.shape[0]), :])
plot(data, np.array(centroids))
# Seleccionar los siguientes k-1 centroides
for c_id in range(k - 1):
dist = []
for i in range(data.shape[0]):
point = data[i, :]
d = sys.maxsize
# Calcular la distancia mínima de cada punto a los centroides seleccionados
for j in range(len(centroids)):
temp_dist = distance(point, centroids[j])
d = min(d, temp_dist)
dist.append(d)
dist = np.array(dist)
# Seleccionar el siguiente centroide como el punto con la distancia máxima
next_centroid = data[np.argmax(dist), :]
centroids.append(next_centroid)
dist = []
plot(data, np.array(centroids))
return centroids
# Inicializar los centroides con k=4
centroids = initialize(data, k=4)


b) Sensibilidad a la escala
Dado que el algoritmo usa distancia euclidiana, las variables con diferentes escalas pueden afectar la agrupación. Es recomendable estandarizar los datos antes de aplicar K-Means.
c) Requiere especificar $ K $
El número de clústeres $ K $ debe ser definido a priori.
d) Supone clusters esféricos
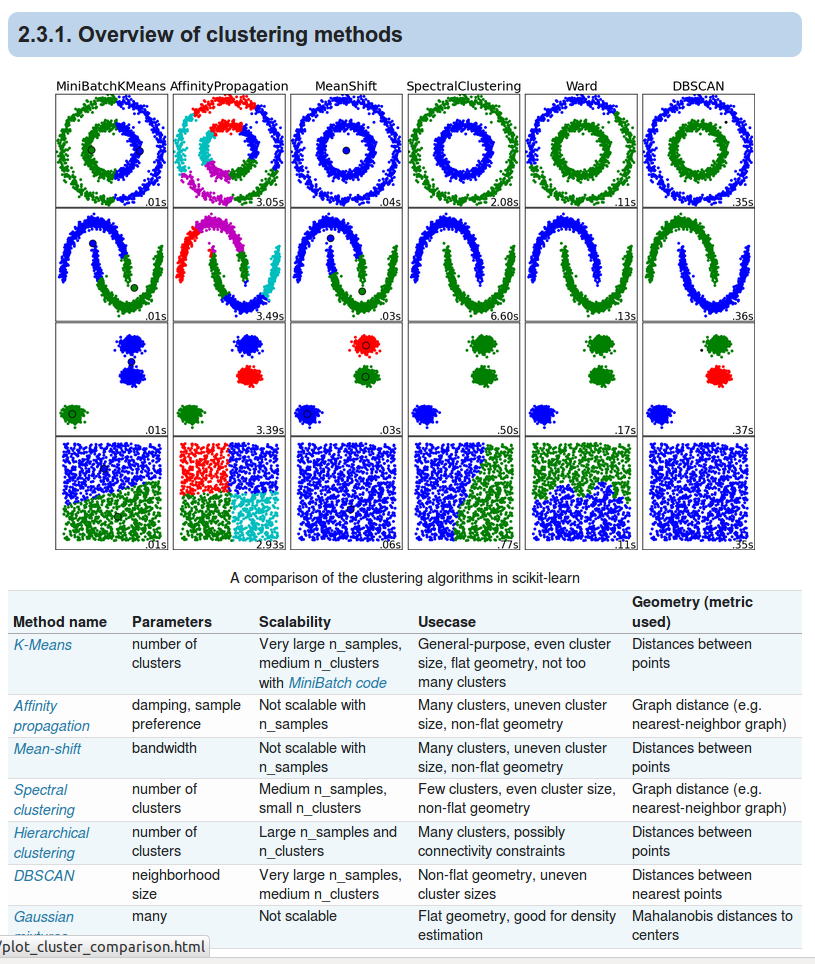
K-Means funciona mejor cuando los grupos son aproximadamente esféricos y tienen varianza similar. No es ideal para estructuras de datos con formas arbitrarias o distribuciones de densidad no uniformes.
e) No maneja bien el ruido y los outliers
Los puntos atípicos pueden afectar significativamente la ubicación de los centroides, lo que puede degradar la calidad del clustering.
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans, DBSCAN, AffinityPropagation, MeanShift, SpectralClustering, AgglomerativeClustering
from sklearn.datasets import make_moons, make_circles, make_blobs
from sklearn.preprocessing import StandardScaler
# Configuración del estilo
sns.set(style="whitegrid")
# Generar conjuntos de datos
datasets = {
"Círculos": make_circles(n_samples=500, factor=0.5, noise=0.05, random_state=42),
"Lunas": make_moons(n_samples=500, noise=0.05, random_state=42),
"Blobs": make_blobs(n_samples=500, centers=3, cluster_std=1.0, random_state=42),
"Aleatorio": (np.random.rand(500, 2), None) # Datos aleatorios sin estructura
}
# Definir algoritmos de clustering
clustering_algorithms = {
"K-Means": KMeans(n_clusters=3, random_state=42, n_init=10),
"Affinity Propagation": AffinityPropagation(damping=0.9),
"MeanShift": MeanShift(),
"Spectral Clustering": SpectralClustering(n_clusters=3, affinity="nearest_neighbors", random_state=42),
"Hierarchical Clustering (Ward)": AgglomerativeClustering(n_clusters=3),
"DBSCAN": DBSCAN(eps=0.2, min_samples=3)
}
# Crear una figura con una cuadrícula de subplots
n_datasets = len(datasets)
n_algorithms = len(clustering_algorithms)
fig, axes = plt.subplots(n_datasets, n_algorithms + 1, figsize=(20, 15))
# Aplicar clustering a cada conjunto de datos con cada algoritmo
for row, (dataset_name, (X, y)) in enumerate(datasets.items()):
# Normalizar datos
X_scaled = StandardScaler().fit_transform(X)
# Graficar datos originales en la primera columna
axes[row, 0].scatter(X_scaled[:, 0], X_scaled[:, 1], s=10, color="gray")
axes[row, 0].set_title(f"Datos: {dataset_name}")
axes[row, 0].set_xticks([])
axes[row, 0].set_yticks([])
# Aplicar cada algoritmo de clustering
for col, (algo_name, algo) in enumerate(clustering_algorithms.items(), start=1):
# Ajustar el algoritmo de clustering
clustering = algo.fit(X_scaled)
# Obtener etiquetas de los clusters
if hasattr(clustering, "labels_"):
labels = clustering.labels_
else:
# Para algoritmos que no tienen labels_, predecir clusters
labels = clustering.fit_predict(X_scaled)
# Graficar los clusters
axes[row, col].scatter(X_scaled[:, 0], X_scaled[:, 1], c=labels, cmap="viridis", s=10)
axes[row, col].set_title(algo_name)
axes[row, col].set_xticks([])
axes[row, col].set_yticks([])
# Ajustar el diseño y mostrar la gráfica
plt.tight_layout()
plt.show()

Clustering Jerárquico
Introducción
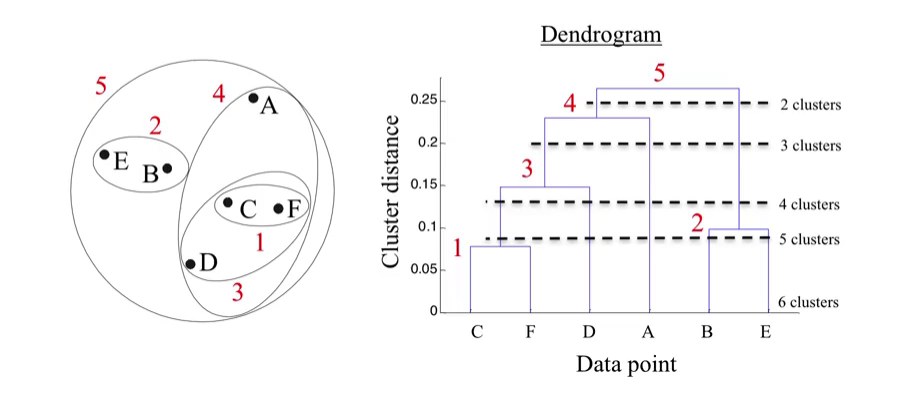
El clustering jerárquico es un método de agrupamiento que no requiere especificar el número de clusters de antemano, a diferencia de K-Means. Se basa en la construcción de una estructura jerárquica de los datos mediante un dendrograma, lo que permite explorar múltiples niveles de agrupación.
Un dendrograma es un diagrama en forma de árbol que representa la estructura de agrupamiento de un conjunto de datos en un algoritmo de clustering jerárquico, permitiendo visualizar cómo los elementos se agrupan en distintos niveles de similitud. Su estructura jerárquica organiza los datos en diferentes niveles, donde cada unión representa la formación de un grupo (cluster), y la proximidad de las ramas indica el grado de similitud entre los elementos. Además, la altura de las uniones en el dendrograma refleja la distancia o disimilitud entre los clusters, lo que permite interpretar la relación entre ellos y determinar el número óptimo de grupos en un conjunto de datos.
Aplicaciones del clustering jerárquico:
- Biología: Análisis filogenético para representar relaciones evolutivas.
- Genética: Agrupamiento de genes con expresiones similares.
- Marketing: Segmentación de clientes en grupos de comportamiento.
- Procesamiento de lenguaje natural: Agrupamiento de textos por similitud.
Definición Formal
Sea un conjunto de datos $ X = \{x_1, x_2, ..., x_n\} $ con $ x_i \in \mathbb{R}^d $. El clustering jerárquico busca construir una jerarquía de grupos basándose en la similitud entre observaciones.
Existen dos enfoques principales:
- Aglomerativo (bottom-up): Comienza con cada punto como un cluster y los fusiona sucesivamente.
- Divisivo (top-down): Comienza con un solo cluster y lo divide recursivamente.
El método más común es el aglomerativo, el cual sigue estos pasos:
- Inicializar cada observación como un cluster individual.
- Calcular las distancias entre todos los clusters.
- Combinar los dos clusters más cercanos.
- Repetir hasta que solo quede un cluster.
Elección de Distancia y Métodos de Vinculación
Para determinar la similitud entre clusters, se utilizan diferentes métricas de distancia y métodos de vinculación. La elección de estas métricas es fundamental, ya que afecta cómo se agrupan los datos y la forma final de los clusters.
a) Métricas de Distancia
Las métricas de distancia determinan cómo se mide la similitud entre dos puntos en el espacio de características. Dependiendo de la naturaleza de los datos y del problema, algunas métricas pueden ser más adecuadas que otras.
1️. Distancia Euclidiana (L2 Norm)
La distancia euclidiana es la métrica más comúnmente utilizada en clustering jerárquico y se define como:
$d_{\text{Euclidiana}}(x_i, x_j) = \sqrt{\sum_{k=1}^{d} (x_{ik} - x_{jk})^2}$
Esta métrica mide la distancia en línea recta entre dos puntos en un espacio $d$-dimensional.
Ventaja:
- Es intuitiva y fácil de calcular.
- Funciona bien en datos con distribuciones gaussianas y clusters esféricos.
Desventaja:
- Sensible a la escala de las variables: Si las características tienen rangos diferentes, las de mayor magnitud dominarán la distancia.
- No maneja bien clusters con formas alargadas o de distinta densidad.
Ejemplo:
Si estamos agrupando clientes por ingresos y edad, la distancia euclidiana puede ser útil si ambas características están escaladas correctamente.
Recomendación (breve desvío):
Si se usa esta métrica, es altamente recomendable estandarizar los datos antes de aplicarla, usando por ejemplo:
La idea central es que StandardScaler() hace que cada variable quede en una escala comparable. Si no estandarizas, una variable con números grandes puede dominar el cálculo de distancia, aunque no sea la más importante.
Qué hace este código
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
`
Se interpreta así:
StandardScaler()crea un objeto que va a estandarizar los datos.fit_transform(X):- fit: calcula, para cada columna de
X, su media y su desviación estándar. - transform: transforma cada valor usando:
- fit: calcula, para cada columna de
$z = \frac{x - \mu}{\sigma}$
donde:
- (x): valor original
- ($\mu$): media de la variable
- ($\sigma$): desviación estándar de la variable
Después de eso, cada variable queda aproximadamente con:
- media 0
- desviación estándar 1
Ejemplo 1: distancia sin estandarizar
Supongamos dos personas descritas por:
- Edad
- Ingreso mensual en pesos
A = [20, 500000]
B = [30, 650000]
La distancia euclidiana entre A y B es:
$d(A,B) = \sqrt{(20-30)^2 + (500000-650000)^2}$
$d(A,B) = \sqrt{(-10)^2 + (-150000)^2}$
$d(A,B) = \sqrt{100 + 22,500,000,000} \approx 150000$
Qué pasó aquí
Aunque la diferencia de edad es 10 años, la diferencia de ingreso es 150000 pesos, y esa escala enorme domina completamente la distancia.
En la práctica:
- la edad casi “no pesa”
- el ingreso decide casi todo
Ejemplo 2: mismo caso, pero estandarizando
Supongamos ahora este dataset:
X = [
[20, 500000],
[30, 650000],
[50, 700000]
]
Paso 1: medias
- media edad = ( $\frac{20+30+50}{3} = 33.33$ )
- media ingreso = ( $\frac{500000+650000+700000}{3} = 616666.67$ )
Paso 2: desviaciones estándar
Aproximadamente:
- desviación estándar edad ( $\approx 12.47$ )
- desviación estándar ingreso ( $\approx 84983.66$ )
Entonces:
Punto A = [20, 500000]
$ z_{\text{edad}}(A) = \frac{20-33.33}{12.47} \approx -1.07 $
$ z_{\text{ingreso}}(A) = \frac{500000-616666.67}{84983.66} \approx -1.37 $
A escalado:
$ A' \approx [-1.07, -1.37] $
Punto B = [30, 650000]
$ z_{\text{edad}}(B) = \frac{30-33.33}{12.47} \approx -0.27 $
$ z_{\text{ingreso}}(B) = \frac{650000-616666.67}{84983.66} \approx 0.39 $
B escalado:
$ B' \approx [-0.27, 0.39] $
Distancia entre A' y B'
$ d(A',B') = \sqrt{(-1.07 - (-0.27))^2 + (-1.37 - 0.39)^2} $
$ d(A',B') = \sqrt{(-0.80)^2 + (-1.76)^2} $
$ d(A',B') = \sqrt{0.64 + 3.10} = \sqrt{3.74} \approx 1.93 $
Qué pasó ahora
Ahora:
- edad e ingreso aportan en una escala comparable
- ninguna variable domina solo por tener números más grandes
- cada diferencia se interpreta en función de la variabilidad típica de su variable
Importante
En este ejemplo, las variables estandarizadas no quedan iguales ni aportan exactamente lo mismo. Eso es normal.
La idea correcta no es:
- “al estandarizar, todas las diferencias quedan iguales”
La idea correcta es:
- “al estandarizar, cada variable pasa a medirse en unidades de su propia dispersión”
Es decir, una diferencia en edad y una diferencia en ingreso ya no se comparan en sus unidades originales, sino en términos de cuántas desviaciones estándar representan.
Intuición general
La distancia euclidiana usual es:
$ d(x_i, x_j) = \sqrt{\sum_{k=1}^{d} (x_{ik} - x_{jk})^2} $
Si una variable tiene escala muy grande, puede dominar el cálculo solo por el tamaño de sus números.
Con estandarización, en la práctica estamos comparando algo más parecido a:
$ d(x_i, x_j) = \sqrt{\sum_{k=1}^{d} \left( \frac{x_{ik} - x_{jk}}{\sigma_k} \right)^2} $
Así, cada diferencia se divide por la desviación estándar de su propia variable.
Conclusión
Estandarizar no hace que todas las variables aporten exactamente lo mismo, pero sí evita que una variable domine la distancia únicamente por estar medida en una escala numérica mayor.
Por eso, en métodos basados en distancia como K-means, clustering jerárquico, KNN o PCA, suele ser recomendable estandarizar las variables antes de aplicar el algoritmo.
Mini ejemplo en Python
import numpy as np
from sklearn.preprocessing import StandardScaler
from scipy.spatial.distance import euclidean
X = np.array([
[20, 500000],
[30, 600000],
[40, 700000]
])
# Distancia sin estandarizar
d_original = euclidean(X[0], X[1])
# Estandarización
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
# Distancia estandarizada
d_scaled = euclidean(X_scaled[0], X_scaled[1])
print("Distancia original:", d_original)
print("Distancia escalada:", d_scaled)
print("\nDatos escalados:\n", X_scaled)
Conceptualmente:
Distancia originalmuy grande, dominada por ingresoDistancia escaladamucho más balanceada
Resumen
Si una variable está en pesos y otra en años, la de pesos puede dominar la distancia solo por su escala. Estandarizar evita que el algoritmo confunda "magnitud numérica" con "importancia real".
Cálculo en Python de la distancia euclidiana
import numpy as np
from scipy.spatial.distance import euclidean
# Definir dos puntos en un espacio 2D
p1 = np.array([3, 4])
p2 = np.array([7, 1])
# Cálculo manual de la distancia Euclidiana
dist_euclid = np.sqrt(np.sum((p1 - p2) ** 2))
print(f"Distancia Euclidiana (manual): {dist_euclid:.4f}")
# Usando scipy
dist_euclid_scipy = euclidean(p1, p2)
print(f"Distancia Euclidiana (scipy): {dist_euclid_scipy:.4f}")
2. Distancia Manhattan (norma L1)
La distancia Manhattan mide la suma de las diferencias absolutas entre coordenadas:
$d_{\text{Manhattan}}(x_i, x_j) = \sum_{k=1}^{d} |x_{ik} - x_{jk}|$
Ventajas:
- Es menos sensible a outliers porque no eleva las diferencias al cuadrado, así que valores extremos no dominan tanto la distancia.
- Puede funcionar mejor en alta dimensión porque reparte la contribución entre variables de forma más estable que la distancia euclidiana.
Desventajas:
- No representa la distancia en línea recta, por lo que no es ideal si la noción de cercanía geométrica es importante.
- Puede inducir clusters no esféricos, porque la cercanía se define por desplazamientos horizontales y verticales acumulados, no por distancia en línea recta, lo que a veces no calza bien con algoritmos o estructuras que esperan otra forma de proximidad.
Ejemplo: Es natural en movimientos sobre una cuadrícula, como calles en una ciudad donde solo se avanza horizontal o verticalmente.
Recomendación: Suele ser útil cuando interesa medir diferencias acumuladas variable por variable, o cuando hay riesgo de que algunos valores extremos distorsionen la distancia.
Cálculo en Python
from scipy.spatial.distance import cityblock
# Cálculo manual de la distancia Manhattan
dist_manhattan = np.sum(np.abs(p1 - p2))
print(f"Distancia Manhattan (manual): {dist_manhattan:.4f}")
# Usando scipy
dist_manhattan_scipy = cityblock(p1, p2)
print(f"Distancia Manhattan (scipy): {dist_manhattan_scipy:.4f}")
Visualización de las distancias
import matplotlib.pyplot as plt
# Puntos
x_values = [p1[0], p2[0]]
y_values = [p1[1], p2[1]]
plt.figure(figsize=(6, 6))
# Distancia Euclidiana (línea recta)
plt.plot(x_values, y_values, 'bo-', label="Distancia Euclidiana", linewidth=2)
# Distancia Manhattan (trayectoria en escalera)
plt.plot([p1[0], p2[0]], [p1[1], p1[1]], 'r--', linewidth=2)
plt.plot([p2[0], p2[0]], [p1[1], p2[1]], 'r--', linewidth=2, label="Distancia Manhattan")
# Configuración del gráfico
plt.scatter(*p1, color='blue', label="Punto 1 (3,4)", s=100)
plt.scatter(*p2, color='red', label="Punto 2 (7,1)", s=100)
plt.legend()
plt.title("Comparación de Distancia Euclidiana vs. Manhattan")
plt.grid()
plt.show()

3. Distancia coseno
La distancia coseno mide la diferencia angular entre dos vectores, en lugar de la distancia absoluta entre sus valores:
$d_{\text{Coseno}}(x_i, x_j) = 1 - \frac{x_i \cdot x_j}{||x_i||, ||x_j||}$
donde:
- ($x_i \cdot x_j$) es el producto punto entre los vectores
- ($||x_i||$) y ($||x_j||$) son sus normas euclidianas
Ventajas:
- Es muy útil en texto y datos de alta dimensión porque en esos casos suele importar más la composición relativa* del vector que su tamaño total.
- Ignora la magnitud y se enfoca en la dirección. Por eso, dos vectores se consideran parecidos si tienen proporciones similares entre sus componentes, aunque uno tenga valores más grandes que el otro.
*¿Por qué importa la composición relativa en texto? Porque en texto muchas veces interesa saber si dos documentos hablan de temas parecidos, no cuál es más largo. Por ejemplo, si dos documentos usan proporciones similares de palabras como "red", "modelo" y "datos", su contenido puede ser parecido aunque uno tenga 100 palabras y otro 1000. La distancia coseno captura esa similitud temática mejor que una distancia basada en magnitudes absolutas.
Desventajas:
- No considera la magnitud del vector, así que puede ser una mala elección si la intensidad, frecuencia total o tamaño sí son relevantes.
- No mide cercanía real en el espacio, sino similitud de orientación. Por eso puede ser menos adecuada cuando importa la distancia absoluta entre observaciones.
Ejemplo: Se usa mucho en análisis de texto, donde cada documento se representa como un vector TF-IDF. Dos documentos pueden tratar temas similares aunque uno sea mucho más extenso que el otro.
Recomendación: Es especialmente útil para datos textuales, embeddings y vectores dispersos, donde la dirección del vector suele ser más informativa que su magnitud.
from sklearn.metrics.pairwise import cosine_distances
cosine_dist = cosine_distances(X)
import numpy as np
from scipy.spatial.distance import cosine
# Definir los puntos
p1 = np.array([3, 4])
p2 = np.array([7, 1])
# Cálculo manual de la distancia del coseno
cosine_similarity = np.dot(p1, p2) / (np.linalg.norm(p1) * np.linalg.norm(p2))
cosine_distance = 1 - cosine_similarity # Distancia coseno
print(f"Similitud del Coseno: {cosine_similarity:.4f}")
print(f"Distancia del Coseno: {cosine_distance:.4f}")
# Usando scipy
dist_cosine_scipy = cosine(p1, p2)
print(f"Distancia del Coseno (scipy): {dist_cosine_scipy:.4f}")
4. Distancia de Mahalanobis
La distancia de Mahalanobis mide qué tan lejos están dos observaciones considerando no solo la escala de cada variable, sino también la correlación entre ellas:
$d_{\text{Mahalanobis}}(x_i, x_j) = \sqrt{(x_i - x_j)^T S^{-1} (x_i - x_j)}$
donde (S) es la matriz de covarianza de los datos.
Ventajas:
- Tiene en cuenta la correlación entre variables, por lo que no trata como independientes variables que en realidad se mueven juntas.
- Ajusta la distancia según la variabilidad de los datos: diferencias en direcciones muy frecuentes pesan menos, y diferencias en direcciones raras pesan más.
- Puede capturar clusters elípticos, porque la noción de cercanía se adapta a la forma real de la nube de datos y no solo a círculos o esferas.
¿Por qué importa la correlación? Porque en muchos datos una combinación de valores puede ser completamente normal si sigue el patrón habitual de covariación. Por ejemplo, si altura y peso están correlacionados, una persona alta y con mayor peso no necesariamente está “lejos” del resto. Euclidiana puede exagerar esa distancia; Mahalanobis la reduce si esa combinación es esperable en los datos.
Desventajas:
- Requiere estimar la matriz de covarianza, lo que puede ser inestable o costoso si hay muchas variables o pocos datos.
- Depende de que la covarianza esté bien estimada; si la estructura de correlación es débil, ruidosa o mal estimada, la distancia puede perder utilidad.
- Es más difícil de interpretar que Euclidiana, porque la distancia ya no depende solo de diferencias directas entre coordenadas.
Ejemplo: Se usa en detección de fraudes o anomalías, donde una observación puede parecer normal en cada variable por separado, pero extraña en su combinación con otras variables. Ejemplo, una transacción puede ser anómala no solo por su monto, sino por su relación con otras variables (ubicación, tipo de compra, frecuencia).
Recomendación: Es útil cuando las variables están correlacionadas y la nube de datos tiene una forma alargada o elíptica, no aproximadamente esférica.
```python id="gq3n1h" from scipy.spatial.distance import mahalanobis import numpy as np
Calcular la matriz de covarianza
cov_matrix = np.cov(X_scaled.T) inv_cov_matrix = np.linalg.inv(cov_matrix)
Calcular distancia de Mahalanobis entre dos puntos
dist = mahalanobis(X_scaled[0], X_scaled[1], inv_cov_matrix) ```
from scipy.spatial.distance import mahalanobis
import numpy as np
# Definir los puntos
p1 = np.array([3, 4])
p2 = np.array([7, 1])
# Crear matriz de datos (p1 y p2 como filas)
X = np.vstack([p1, p2])
# Calcular la matriz de covarianza
cov_matrix = np.cov(X.T)
# Usar la pseudoinversa en lugar de la inversa para evitar el error de matriz singular
inv_cov_matrix = np.linalg.pinv(cov_matrix)
# Cálculo de la distancia de Mahalanobis
dist_mahalanobis = mahalanobis(p1, p2, inv_cov_matrix)
print(f"Distancia de Mahalanobis: {dist_mahalanobis:.4f}")
### Ejemplo comparativo
import numpy as np
from scipy.spatial.distance import mahalanobis
# Datos correlacionados
X = np.array([
[40, 42],
[45, 46],
[50, 51],
[55, 54],
[60, 61]
])
# Centro aproximado
mu = X.mean(axis=0)
# Matriz de covarianza e inversa
S = np.cov(X.T)
S_inv = np.linalg.inv(S)
# Puntos a comparar
A = np.array([60, 60]) # sigue la correlación #por que este punto no se usa para calcular la matriz de covarianza? porque es un nuevo punto que queremos evaluar, no forma parte del conjunto de datos original
B = np.array([60, 40]) # rompe la correlación
# Distancias euclidianas
dE_A = np.linalg.norm(A - mu)
dE_B = np.linalg.norm(B - mu)
# Distancias Mahalanobis
dM_A = mahalanobis(A, mu, S_inv)
dM_B = mahalanobis(B, mu, S_inv)
print("Centro:", mu)
print("Euclidiana A:", dE_A)
print("Euclidiana B:", dE_B)
print("Mahalanobis A:", dM_A)
print("Mahalanobis B:", dM_B)
Interpretación
Para Euclidiana:
- A y B están a distancias relativamente parecidas
- B sale un poco más lejos, pero no muchísimo más
¿Por qué? Porque Euclidiana solo mira "cuánto se movió" el punto en términos geométricos, sin preguntarse si esa dirección es normal o rara dado el patrón de los datos.
Qué está diciendo Mahalanobis
Mahalanobis no solo mira tamaño del desplazamiento. También mira:
- la varianza en cada dirección
- la correlación entre variables
Eso significa que pregunta algo más sofisticado:
¿Este punto está lejos en una dirección que es habitual en los datos, o en una dirección que rompe el patrón?
Por qué A tiene Mahalanobis pequeña
El punto:
$A=(60,60)$
está por encima del promedio en ambas variables. Eso sigue la tendencia natural de los datos: cuando una sube, la otra también.
Entonces, aunque geométricamente A no esté pegado al centro, sí está en una dirección esperable dada la correlación.
Por eso:
$d_M(A,\mu)\approx 1.26$
que es una distancia pequeña.
A está lejos en sentido geométrico, pero no está lejos en sentido estadístico.
Por qué B tiene Mahalanobis enorme
El punto:
$B=(60,40)$
tiene primera variable alta, pero segunda variable baja.
Eso rompe completamente el patrón de los datos. Dado que las variables suelen crecer juntas, esta combinación es muy inusual.
Por eso Mahalanobis lo castiga fuertemente:
$d_M(B,\mu)\approx 22.40$
B no solo está desplazado: está desplazado en una dirección muy improbable según la estructura conjunta de los datos.
Entonces
- Euclidiana mide "qué tan lejos está"
- Mahalanobis mide "qué tan raro es estar ahí, dada la forma de la nube"
Por qué la diferencia es tan extrema
La nube de datos está muy alineada con una diagonal ascendente. Eso implica:
- moverse a lo largo de esa diagonal es relativamente normal
- moverse perpendicularmente a esa diagonal es raro
A está cerca de la diagonal de correlación. B está muy fuera de esa diagonal.
Entonces Mahalanobis hace algo parecido a esto:
- "premia" movimientos en la dirección natural de la nube
- "penaliza" movimientos transversales a esa estructura
A y B están a una distancia geométrica parecida del centro, por eso Euclidiana los ve como relativamente similares. Pero los datos muestran que ambas variables suelen aumentar juntas. A respeta ese patrón, B lo rompe. Mahalanobis incorpora esa información y por eso considera a B muchísimo más lejano. Es decir, Euclidiana mide distancia. Mahalanobis mide distancia corregida por la forma y correlación de los datos.
Conclusión
Este ejemplo muestra por qué Mahalanobis puede ser mejor cuando hay variables correlacionadas:
- no sobrecastiga combinaciones que siguen el patrón normal de covariación
- sí detecta como lejanas combinaciones atípicas, aunque Euclidiana no las vea tan extremas
Comparación de Distancias
| Distancia | Uso Ideal | Ventaja | Desventaja |
|---|---|---|---|
| Euclidiana | Clusters esféricos | Intuitiva y fácil de calcular | Sensible a la escala |
| Manhattan | Datos dispersos o en cuadrícula | Robusta a outliers | Puede no capturar relaciones geométricas |
| Coseno | Texto y datos de alta dimensión | Enfocada en similitud de dirección | No considera magnitud |
| Mahalanobis | Datos correlacionados y clusters elípticos | Ajusta por correlación | Computacionalmente costosa |
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs, make_moons, make_circles
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster
from scipy.spatial.distance import pdist
# Generar datasets con diferentes características
np.random.seed(42)
# Dataset 1: Blobs (clusters esféricos)
X1, y1 = make_blobs(n_samples=300, centers=3, cluster_std=1.0)
# Dataset 2: Moons (clusters en forma de media luna)
X2, y2 = make_moons(n_samples=300, noise=0.05)
# Dataset 3: Circles (clusters concéntricos)
X3, y3 = make_circles(n_samples=300, factor=0.5, noise=0.05)
# Lista de datasets para iterar
datasets = [(X1, y1, "Blobs"), (X2, y2, "Moons"), (X3, y3, "Circles")]
# Métricas de distancia a comparar
metrics = ['euclidean', 'cityblock', 'cosine', 'mahalanobis']
# Métodos de linkage a utilizar
linkage_methods = ['single'] # Puedes añadir 'complete', 'average' si lo deseas
# Función para encontrar el corte óptimo usando el método del codo
def find_optimal_cutoff(Z):
#La idea detrás de este método es encontrar el punto en el dendrograma donde la distancia de
#fusión aumenta drásticamente, lo que indica que los clusters restantes son demasiado disímiles
#para ser fusionados sin pérdida de información.
#El número óptimo de clusters está justo antes de este gran salto en la distancia de fusión.
# Obtener las últimas 10 distancias de fusión/unión, que corresponden a las fusiones más grandes (las últimas uniones de clusters).
last = Z[-10:, 2]
# Invertir el orden de las distancias
last_rev = last[::-1]
# Crear un array de índices
idxs = np.arange(1, len(last) + 1)
# Se calcula la segunda derivada discreta de las distancias para medir la variación en la tasa de cambio.
# La segunda derivada mide la "curvatura" de la función de distancia de fusión y ayuda a detectar un punto de inflexión (donde la tasa de cambio es máxima).
acceleration = np.diff(last, 2)
# Invertir el orden de la aceleración
acceleration_rev = acceleration[::-1]
# Encontrar el índice de la máxima aceleración
k = acceleration_rev.argmax() + 2 # Si el índice es 0, necesitamos 2 clusters
# Devolver la distancia en el punto de corte óptimo
return Z[-k, 2]
# Función para aplicar clustering jerárquico y visualizar los dendrogramas
def plot_dendrograms(X, dataset_name, ax, metric, method, cutoff):
# Aplicar el clustering jerárquico
Z = linkage(X, method=method, metric=metric)
# Dibujar el dendrograma
dendrogram(Z, ax=ax, truncate_mode='level', p=5)
# Añadir una línea horizontal en el punto de corte
ax.axhline(y=cutoff, c='r', linestyle='--')
# Establecer el título del subplot
ax.set_title(f'{dataset_name} - {metric.capitalize()} - {method.capitalize()}')
# Función para aplicar clustering jerárquico y visualizar los clusters
def plot_clusters(X, dataset_name, ax, metric, method, cutoff):
# Aplicar el clustering jerárquico
Z = linkage(X, method=method, metric=metric)
# Formar clusters cortando el dendrograma en la distancia de corte
clusters = fcluster(Z, t=cutoff, criterion='distance')
# Dibujar un scatter plot de los datos, coloreando los puntos según los clusters formados
ax.scatter(X[:, 0], X[:, 1], c=clusters, cmap='viridis', marker='.')
# Establecer el título del subplot
ax.set_title(f'{dataset_name} - {metric.capitalize()} - {method.capitalize()} Clusters')
# Crear una figura con subplots para comparar las métricas
fig, axs = plt.subplots(len(datasets) * 2, len(metrics) * len(linkage_methods) + 1, figsize=(30, 30))
# Iterar sobre los datasets
for i, (X, y, dataset_name) in enumerate(datasets):
# Plot de los datos originales con sus etiquetas verdaderas
ax = axs[i * 2, 0]
scatter = ax.scatter(X[:, 0], X[:, 1], c=y, cmap='viridis', marker='.')
ax.set_title(f'{dataset_name} - Ground Truth')
# Iterar sobre las métricas de distancia
for j, metric in enumerate(metrics):
# Iterar sobre los métodos de linkage
for k, method in enumerate(linkage_methods):
# Aplicar el clustering jerárquico
Z = linkage(X, method=method, metric=metric)
# Encontrar el corte óptimo
cutoff = find_optimal_cutoff(Z)
# Dibujar el dendrograma con el corte óptimo
plot_dendrograms(X, dataset_name, axs[i * 2, j * len(linkage_methods) + k + 1], metric, method, cutoff)
# Dibujar los clusters formados con el corte óptimo
plot_clusters(X, dataset_name, axs[i * 2 + 1, j * len(linkage_methods) + k + 1], metric, method, cutoff)
# Ajustar el espaciado entre subplots para que no se solapen
plt.tight_layout()
# Mostrar la figura
plt.show()